ゲノムデータ解析におけるSINET6の役割
東京大学医科学研究所(以下、東大医科研)は、医療およびバイオテクノロジーの分野で、ヒトゲノム(全遺伝情報)をはじめとする大規模な生命科学データの解析を推進しています。東大医科研が運用するスーパーコンピュータ「SHIROKANE」とSINETを活用したゲノムデータ解析研究の最前線、さらに一人ひとりに適した薬剤や治療計画を選ぶ個別化医療を目指す取り組みについて、ヒトゲノム解析センター長の井元清哉教授と斉藤あゆむ技術専門職員にお話を伺いました。(インタビュー実施:2026年7月7日)
東大医科研ヒトゲノム解析センターの概要について教えてください。
井元氏:東大医科研は、感染症やがんなどの疾患の分子生物学的基礎研究から医科研附属病院における研究成果の社会実装、すなわちトランスレーショナルリサーチを推進する研究所です。その中で「ヒトゲノム解析センター」は、1990年に開始された国際ヒトゲノム計画を背景として、日本におけるゲノム情報の解析基盤を担うことを目的に1991年に設立されました。1993年から大型計算機システムを導入し、国内のゲノムデータ解析を支えてきました。
国際ヒトゲノム計画では、各国の研究機関からなる国際コンソーシアムが2001年にヒトゲノムのドラフト配列を公表し、2003年にヒト標準ゲノム配列の構築完了を発表しました。その後、次世代シークエンサーの登場により、一人ひとりのゲノムを解析できる時代になりました。私たちのセンターでも、2008年に理化学研究所とともに国際がんゲノムコンソーシアム(ICGC)へ参画したことを契機として、次世代シークエンサーから生み出される大規模ながんゲノムデータの解析に取り組み始めました。最初のヒトゲノム計画には巨額の費用と長い年月を要しましたが、シークエンス技術の進歩により、現在では塩基配列を読み取るための試薬費は大幅に低下しています。その結果、生成されるデータ量は急速に増え、保存すべきデータも増え続けています。大規模データを扱うための計算資源と、それを使いこなす研究者・技術者の需要は高まる一方です。
また、現在のゲノム研究では、DNAの塩基配列(ATGCの並び)に加えて、細胞内でつくられるRNAを網羅的に調べるトランスクリプトーム、タンパク質を調べるプロテオーム、代謝物を調べるメタボロームなどを統合する「マルチオミクス解析」が広がっています。さらに、個々の細胞を調べるシングルセル解析も発展しています。これらの解析を組み合わせて健常な状態と疾患の状態を比較し、発症や進行に伴ってDNA、RNA、タンパク質、代謝物や細胞の状態がどのように変化するかを明らかにすることで、病気が発症する原理の理解や治療法・予防法の確立に役立てたいと考えています。
また、2020年5月には、COVID-19感染者の臨床情報とDNA、RNA、血漿などの検体を収集し、重症化に関連する因子の探索やワクチン開発につなげることを目指す「コロナ制圧タスクフォース」が発足しました。私は発起人の一人として参画し、これまでに約6,400人の感染者の臨床情報と検体を収集しました。まずSNP(DNAの中の1つの塩基が別の塩基に置き換わったもの)アレイを用いてゲノム上の多数のSNPを測定し、重症例と非重症例を比較するGWAS(ゲノムワイド関連解析)によって、重症化に関連するゲノム多型を探索しました。その成果の一つとして、DOCK2遺伝子の発現を調節するプロモーター領域にあるSNPを同定しました。このSNPのリスク型は欧米人集団ではほとんどみられない一方、日本人を含む東アジア人集団では約10~20%の頻度で存在します。また、リスク型を持つ場合にはDOCK2の発現が低いことも確認しました。さらに、最終的には全症例を対象に全ゲノムシークエンスを実施し、数千例規模のRNAシークエンスとプロテオーム解析、メタボローム解析も行いました。これらの膨大なデータの管理と解析には、ヒトゲノム解析センターのSHIROKANEが用いられました。
スーパーコンピュータ「SHIROKANE」についても伺います。
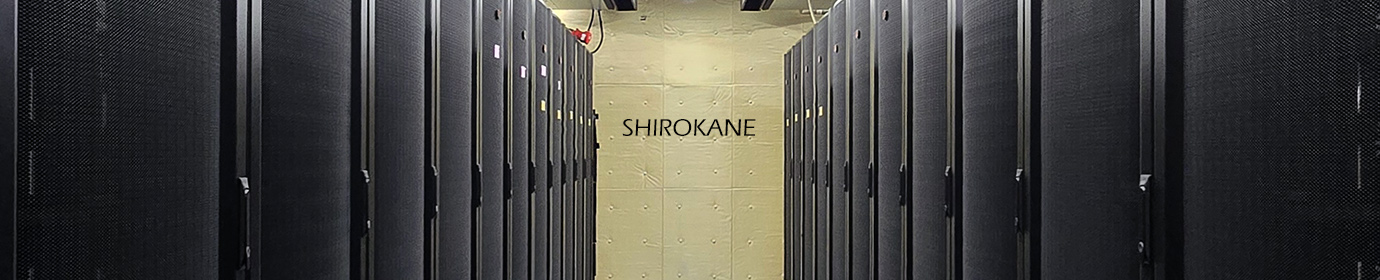
井元氏:「SHIROKANE」は、ゲノム情報をはじめとする大規模な生命科学・医科学データの解析を支えるスーパーコンピュータシステムの総称です。約2年ごとに新世代システムを導入し、各世代を4年間運用します。新旧2世代を並行稼働させ、それらを合わせて「SHIROKANE」と呼んでいます。2026年4月からは、Shirokane7とShirokane8を組み合わせたシステムがSHIROKANEとして稼働しています。
解析手法の発達に伴い、ゲノム解析で扱うデータ量は年々増加しています。例えば、がん患者1人分の全ゲノム解析では、正常組織から取得したゲノムデータと腫瘍組織から取得したゲノムデータを比較します。両者を合わせた生データは約300~400GBで、解析過程ではさらに約600~800GBのデータが生成され、合計で約1~1.5TBになります。SHIROKANEは、こうした大規模データを解析する研究者を支える基盤です。利用者は2015年夏には約600アカウントでしたが、2026年4月には4,100アカウントを超えました。2026年4月に稼働を開始したShirokane8は41PBのストレージを備えています。
また、Shirokane6からShirokane8へのデータ移行では、全国の研究者から預かっている約30PBの研究データを、通常の計算業務への影響を最小限に抑えながら移行する必要がありました。システム担当者と日立製作所のSEチームが連携し、データを失うことなく、約110日間で移行を完了しました。本当に気を遣う作業でした。
ネットワーク構成についても教えてください。
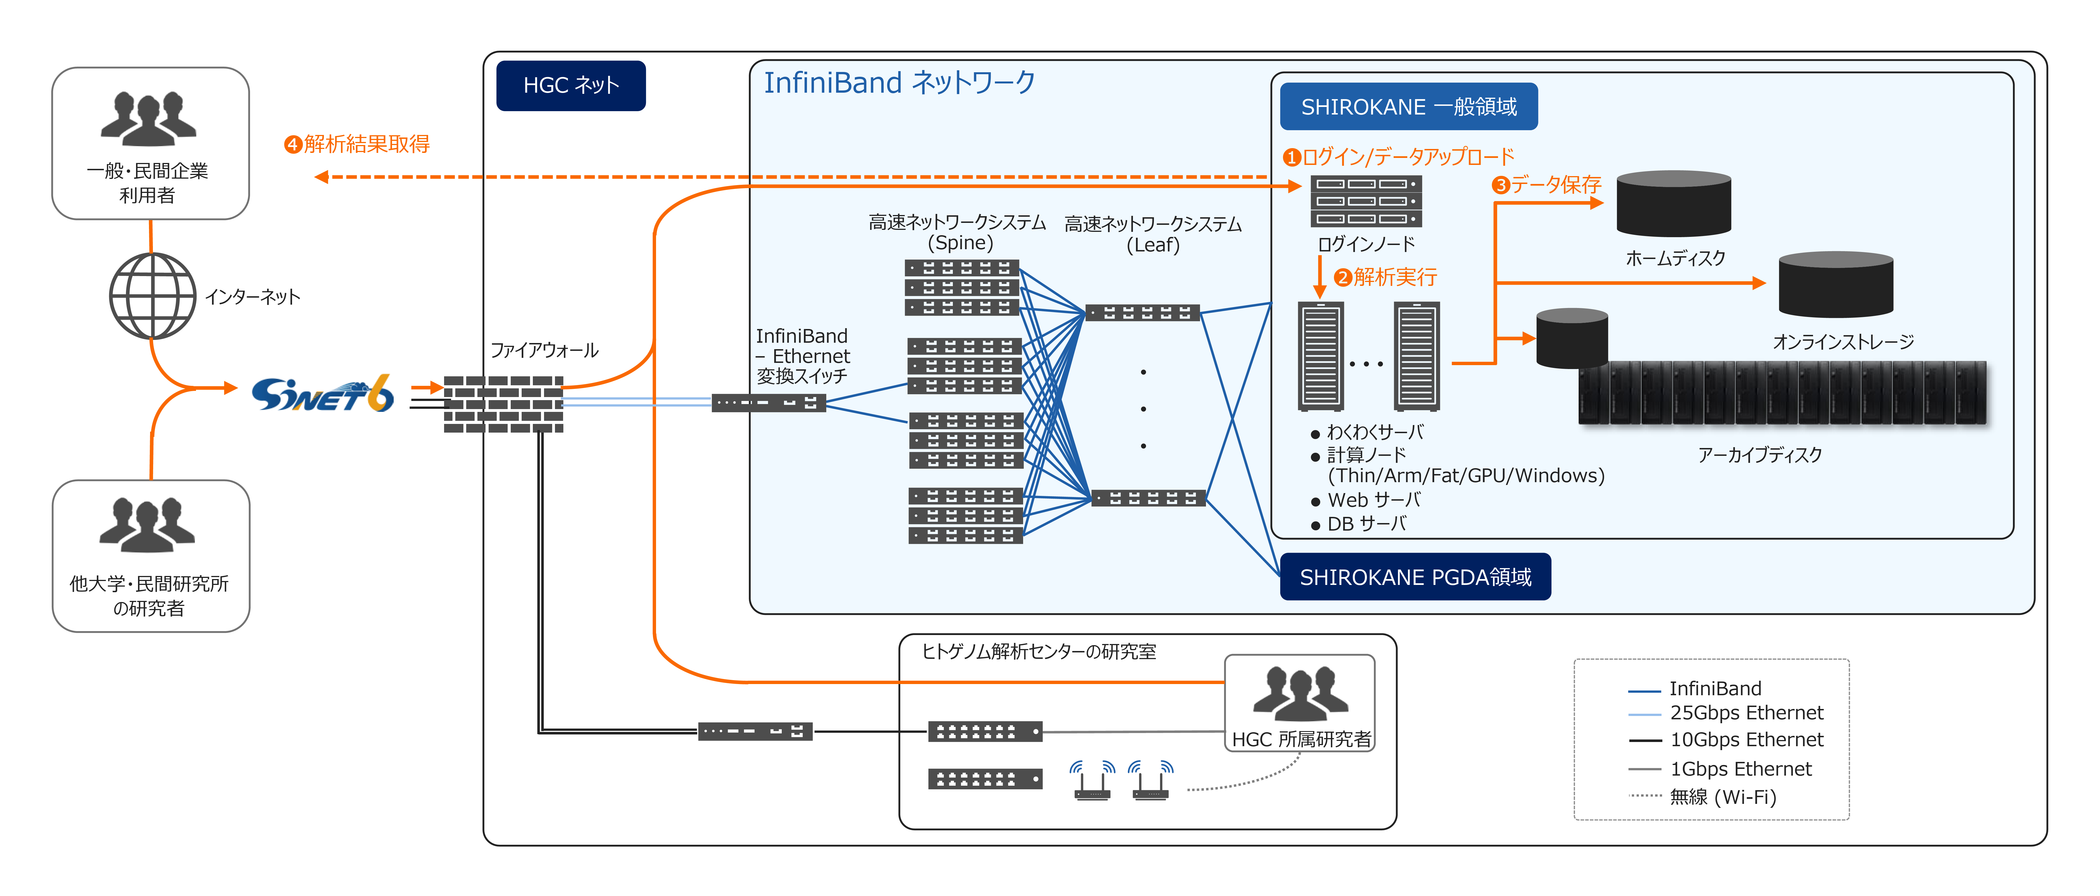
斉藤氏:各機関や共同研究先の民間企業では、SINETを経由してゲノムデータをSHIROKANEへ転送しています。SHIROKANEの内部ネットワークにはSpine-Leafアーキテクチャを採用し、多数の計算ノードからストレージへのアクセスが集中してもボトルネックが生じにくいよう設計しています。
ヒトゲノムデータは、個人を識別し得る機微性の高い情報です。かつては、数百GBからTB級のデータを転送するため、暗号化した外付けハードディスクに保存し、研究者が物理的に搬送することも珍しくありませんでした。この方法には時間と労力がかかり、機器の故障や紛失のリスクも伴います。現在では、各研究機関で暗号化などの安全管理措置を講じたうえで、SINETの高速な学術ネットワークや、インターネットから論理的に分離されたL2VPN/VPLSを利用して転送できるようになり、物理媒体による搬送は大きく減りました。
患者から取得したデータを共同研究で利用、提供、転送する場合は、その方法を研究計画に明記し、関係機関で倫理審査を受けています。ヒトゲノム解析センターでは、情報系の研究者とSHIROKANEの運用担当者が緊密に連携しています。センターの教員も倫理審査委員会に情報系の委員として参画し、暗号化などの安全管理措置やSINETのVPNによる論理的なネットワーク分離について説明しながら、適切なデータ転送方法の検討に加わってきました。
また、シークエンス受託会社から、AWSなどのクラウド経由でデータの納品を受けるケースも増えています。SINETのクラウド接続サービスを利用すると、AWS Direct Connectを経由して大容量データを安定して転送できます。AWSからのデータ転送には料金がかかりますが、インターネット経由よりもDirect Connectのデータ転送単価が低く、条件を満たす場合はデータ転送料の減免を受けられることもあります。
今後の展望について教えてください。
井元氏:医療現場では、患者の遺伝的体質に基づいて薬の効果や副作用を予測し、薬剤や投与量の選択に役立てる「ゲノム薬理学」が、今後さらに広がると考えています。一方、がん医療では、がん細胞に生じた後天的なゲノム変異を調べ、治療薬の選択に役立てる取り組みが進んでいます。こうした解析により、効果が期待しにくい薬剤や副作用のリスクが高い薬剤を避け、患者一人ひとりに適した治療を選択できる可能性があります。また、日本では生後数日の新生児の足底から採血し、先天性代謝異常などを早期に発見する新生児マススクリーニングが行われています。ゲノム解析を迅速化できれば、早期に診断できる遺伝性疾患の範囲を広げられる可能性があります。米国では、遺伝性疾患が疑われる重症新生児を対象に、24時間以内のゲノム診断を目指す取り組みも進められています。
現在、国家プロジェクトとしてがんと難病を中心に全ゲノム解析の結果を患者還元する取り組みが推進されています。我々は、がん領域の解析・データセンターとして活動しており、昨年度は3,000症例の全ゲノムデータを受け取り、解析を実施しました。これまでに2万を超えるがん患者の全ゲノムデータを受け取り、解析しています。難病を合わせて現在の計画は、年間7,000症例で、これを早期に1万症例にスケールアップすることを計画しています。一方、厚生労働省の「全ゲノム解析等実行計画」に関する専門委員会で示された将来像では、ステージIII・IVを中心とするがん患者約30万人に、難病患者・家族などを加え、年間30万~40万人規模の全ゲノム解析を行うことが想定されています。対象人数だけでも、早期の到達目標である年間1万症例と比べて30~40倍です。さらに、全ゲノムシークエンスやマルチオミクス解析が広がれば、データ転送量は現在の約50倍に増える可能性があります。
大規模なゲノムデータを一つの拠点に集約する方法には、通信帯域や個人情報保護の観点から限界があります。災害やシステム障害が起きても研究データを保全し、解析業務を継続・早期復旧できるようにするため、遠隔地の安全なデータセンターへのリアルタイムバックアップや通信帯域の強化も不可欠です。SINETの高速な学術ネットワークと論理的に分離されたVPNサービスを活用することで、地域の医療機関から高度なゲノム解析基盤を利用できる環境を整え、地域間の医療格差の縮小や遠隔医療の発展に貢献できる可能性があります。そうした基盤としての役割もSINETに期待しています。